· DevOps · 9 Min. Lesezeit
Standort-Tracking mit Datenhoheit: OwnTracks, Dawarich und Home Assistant
Anwesenheit und Standort automatisieren, ohne die Bewegungsdaten an eine fremde Cloud zu geben. Der vollständige Aufbau mit Prüfbefehl nach jedem Schritt, dazu sechs Stolpersteine, darunter einer, der ein völlig intaktes Gerät stundenlang tot aussehen lässt.
Anwesenheitserkennung ist bequem. Das Licht geht an, wenn jemand heimkommt, die Heizung reagiert auf Abwesenheit. Der Haken an den üblichen Wegen ist, dass sie ein laufendes Bewegungsprofil an einen fremden Anbieter schicken. Bewegungsdaten gehören zum Sensibelsten, was sich über einen Menschen erfassen lässt, und sie betreffen selten nur die Person, die das System einrichtet.
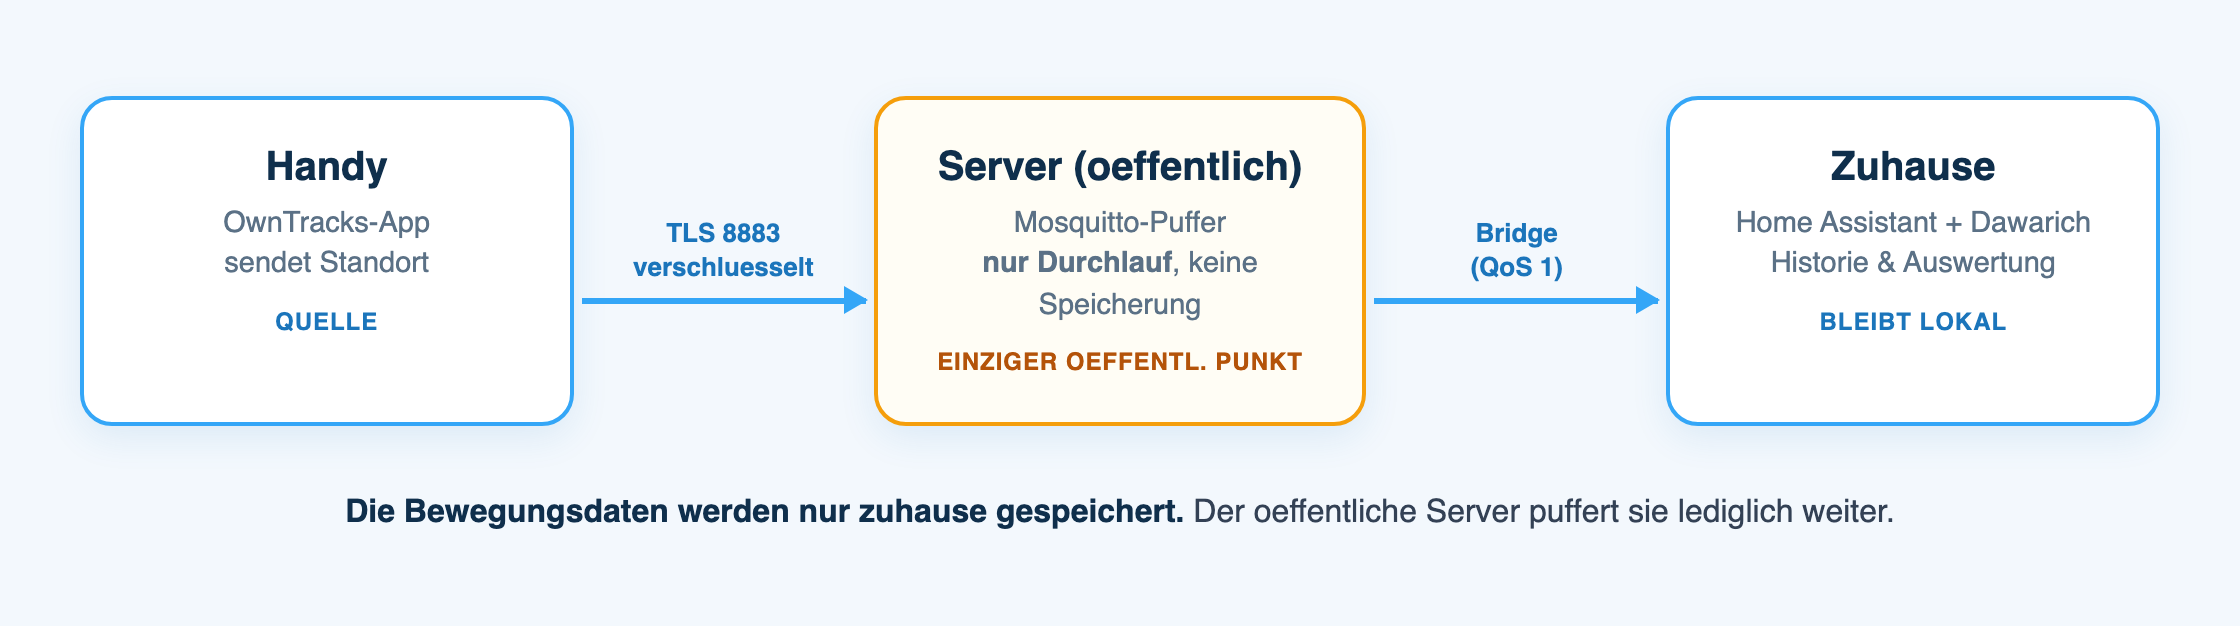
Deshalb ist die tragende Entscheidung in dieser Kette keine technische, sondern eine über den Datenfluss: Der einzige öffentlich erreichbare Punkt speichert nichts. Er reicht durch. Alles, was Historie ist, liegt zu Hause.
Dieser Beitrag zeigt den Aufbau mit einem Prüfbefehl nach jedem Schritt und danach sechs Stolpersteine im Schema Symptom, Ursache, Prüfung, Lösung. Der fünfte ist der lehrreichste, weil er ein vollständig intaktes Gerät stundenlang tot aussehen lässt.
Die Architekturentscheidung
Für Standortdaten aufs eigene System gibt es drei Wege, und sie unterscheiden sich vor allem darin, was im Schadensfall abfließt.
| Fremder Dienst | Öffentlicher Puffer, Historie lokal | Nur über VPN | |
|---|---|---|---|
| Bewegungsprofil beim Betreiber | ja | nein | nein |
| Handy sendet ohne Dauertunnel | ja | ja | nein |
| Bei Kompromittierung erreichbar | Vollprofil | nur die laufende Nachricht | nichts |
| Akkuverbrauch am Gerät | gering | gering | höher |
| Einrichtungsaufwand | keiner | mittel | gering |
Der mittlere Weg ist der Kompromiss, für den ich mich entschieden habe. Ein kleiner, öffentlich erreichbarer MQTT-Broker nimmt die Meldungen an und hält nichts dauerhaft. Eine Bridge zieht sie ins Heimnetz. Dort erst entstehen Historie und Auswertung.
Der Gewinn ist konkret: Wird dieser öffentliche Server kompromittiert, findet der Angreifer keine Historie, sondern bestenfalls die gerade durchlaufende Position. Der reine VPN-Weg wäre noch strenger, kostet aber einen dauerhaften Tunnel auf jedem Gerät und damit Akku.
Voraussetzungen prüfen
Ein Broker, der TLS selbst terminiert. Naheliegend wäre, MQTT über den vorhandenen Reverse Proxy laufen zu lassen und per SNI zu routen. Darauf würde ich mich nicht verlassen. SNI-basiertes Routing setzt voraus, dass der Client den Servernamen im TLS-Handshake mitschickt, und MQTT-Clients tun das nicht durchgängig. Ein eigener Port, an dem der Broker das TLS selbst beendet, macht die Kette unabhängig von dieser Eigenschaft. Das ist eine Zeile mehr Konfiguration und ein Problem weniger.
Ein Topic-Schema, das ACLs erlaubt. OwnTracks baut Topics als owntracks/<benutzer>/<geraet>, dazu Suffixe wie /cmd und /event. Die Doku zu den Topics weist ausdrücklich darauf hin, dass die Zahl der Ebenen unter einer Wurzel gleich bleiben muss, weil sonst keine sauberen Zugriffsregeln möglich sind. Planen Sie das vorher, nachträglich umbauen heißt jedes Gerät neu konfigurieren.
Ein Konto je Gerät. Nicht ein gemeinsames. Sonst können Sie später weder Rechte trennen noch nachvollziehen, welches Gerät was gemeldet hat.
Schritt 1: Den öffentlichen Broker aufsetzen
Der Broker bekommt einen dedizierten TLS-Port, eine Passwortdatei und eine ACL-Datei. Jedes Gerät schreibt nur auf seinen eigenen Zweig.
Prüfung vom Arbeitsrechner aus, mit der eigenen CA:
mosquitto_sub -h broker.lab.rz.jabi-it.de -p 8883 \
  --cafile ca.crt --tls-version tlsv1.3 \
  -u geraet1 -P "$PW" -t 'owntracks/#' -v
Kommt hier eine Verbindung zustande und bleibt sie stehen, ist die Basis in Ordnung. Zur erzwungenen TLS-Version siehe Stolperstein 1.
Schritt 2: Die Bridge ins Heimnetz
Der Broker zu Hause holt sich die Nachrichten aktiv. Das ist wichtig, denn so braucht es keinen eingehenden Weg von außen ins Heimnetz.
Für Bridges ist cleansession laut mosquitto.conf-Doku standardmäßig false, und das ist hier genau richtig: Die Abonnements auf der Gegenseite bleiben erhalten, wenn die Verbindung abreißt, und die Nachrichten aus der Lücke kommen nach.
Prüfung auf dem Heim-Broker:
mosquitto_sub -h localhost -t 'owntracks/#' -vErscheinen hier die Meldungen, die der öffentliche Broker sieht, steht die Bridge.
Schritt 3: Die Historie
Dawarich speichert und wertet aus. Es läuft als Docker-Stack aus mehreren Containern, die Doku beschreibt den Aufbau mit Datenbank, Cache, Worker und Anwendung.
Dawarich spricht selbst kein MQTT. Dazwischen gehört ein kleiner Feeder, der auf dem Heim-Broker mithört und die Positionen an die HTTP-Schnittstelle weiterreicht. Wichtig ist dabei nur eine Eigenschaft: Er darf die MQTT-Nachricht erst quittieren, wenn die Speicherung bestätigt ist. Sonst verlieren Sie bei jedem Neustart genau die Punkte, die gerade unterwegs waren.
Prüfung: Nach einem Testpunkt muss der Punkt in der Oberfläche auftauchen. Erscheint er nicht, sehen Sie in den Feeder-Logs nach, ob der POST überhaupt beantwortet wurde.
Schritt 4: Home Assistant
Home Assistant liest denselben Heim-Broker über die MQTT-Integration und macht daraus Anwesenheit und Zonen.
An dieser Stelle lohnt der Blick in die HA-Doku auf den Abschnitt zu retained Messages. Dort steht der Satz, der die ganze Kette betrifft: Retained Messages bleiben am Broker liegen, auch wenn das Gerät oder der Dienst längst nicht mehr arbeitet. Warum das gefährlich ist, steht unter Stolperstein 5.
Die sechs Stolpersteine
1. Die Verbindung scheitert an der TLS-Version
Symptom: Der Verbindungsversuch bricht mit einer Meldung über ein unbekanntes Zertifikat oder einen Protokollfehler ab, obwohl die CA-Datei korrekt ist.
Ursache: Der Client handelt eine TLS-Version aus, mit der der Listener in dieser Konstellation nicht arbeitet. Die Fehlermeldung deutet auf das Zertifikat, das Problem liegt aber eine Ebene tiefer.
Prüfung: Denselben Befehl einmal mit erzwungener Version wiederholen.
mosquitto_sub -h broker.lab.rz.jabi-it.de -p 8883 \
  --cafile ca.crt --tls-version tlsv1.3 -u geraet1 -P "$PW" -t 'owntracks/#' -v
Lösung: Die Version im Client erzwingen. Das gilt für jeden Aufruf, auch für Testbefehle aus Home Assistant heraus. Wer das einmal vergisst, sucht den Fehler beim Zertifikat.
2. Die Zugriffsregeln blocken Fernbefehle
Symptom: Standortmeldungen laufen einwandfrei, aber Befehle an das Gerät kommen nie an. Kein Fehler, keine Reaktion.
Ursache: Der Account, über den die Befehle laufen, hat nur Leserechte auf den Topic-Baum. Ein Bridge-Konto, das Positionen abholt, braucht read. Zum Senden von Befehlen braucht es zusätzlich write auf den /cmd-Zweig, und daran denkt man beim Einrichten nicht, weil die Kette in Senderichtung ja funktioniert.
Prüfung: Mit einem Konto, das schreiben darf, direkt auf das Befehls-Topic publizieren und gleichzeitig auf dem Topic-Baum mithören.
Lösung: Entweder dem Bridge-Konto gezielt topic write owntracks/+/+/cmd geben, oder einen eigenen, minimalen Account nur für Befehle anlegen. Ich bevorzuge das Zweite, weil ein Konto dann genau eine Aufgabe hat.
3. Die Regeländerung erfordert keinen Neustart
Kein Fehler, sondern ein nützliches Detail, das oft übersehen wird.
Symptom: Nach jeder ACL-Änderung wird der Broker neu gestartet, alle Clients fliegen raus und verbinden sich neu.
Ursache: Unnötig. Mosquitto lädt seine Konfiguration auf ein SIGHUP neu, und die Doku hält für die ACL-Datei ausdrücklich fest, dass die geladenen Regeln freigegeben und neu eingelesen werden.
Lösung:
docker kill -s HUP mosquittoPasswortdatei und ACL sind sofort aktiv, bestehende Verbindungen bleiben stehen. Achtung: Nicht jede Option lässt sich so nachladen, für Bridge-Änderungen greift ein eigener Mechanismus beim Reconnect.
4. Die Auswertung antwortet mit 403
Symptom: Der Feeder bekommt auf jeden POST eine 403 zurück, im Browser funktioniert dieselbe Anwendung einwandfrei.
Ursache: Dawarich läuft auf Rails, und Rails weist Anfragen ab, deren Host-Header nicht in der Freigabeliste steht. Der Browser spricht die Anwendung unter einem anderen Namen an als der Feeder, der sie im Container-Netz unter dem Dienstnamen erreicht.
Prüfung: Den POST einmal von Hand absetzen und den Statuscode ansehen.
curl -s -o /dev/null -w '%{http_code}\n' -X POST \
  "http://dawarich-app:3000/api/v1/owntracks/points?api_key=$KEY" \
  -H 'Content-Type: application/json' -d '{}'
Lösung: Alle Namen in die Freigabeliste aufnehmen, unter denen die Anwendung erreicht wird, und zwar auch den internen Dienstnamen. Genau der wird vergessen, weil im Browser ja alles läuft.
5. Ein intaktes Gerät sieht stundenlang tot aus
Das ist der Stolperstein, der die meiste Zeit frisst, und er ist reine Diagnostik.
Symptom: Ein Gerät scheint seit vielen Stunden keine Position mehr gemeldet zu haben. Die gespeicherte letzte Position ist alt und bewegt sich nicht.
Ursache: Die Prüfung sieht die retained Nachricht an, also den vom Broker gespeicherten letzten Stand. Ein Client, der ohne Retain-Flag publiziert, aktualisiert diesen Stand nie. Live laufen die Positionen völlig normal durch, nur der gespeicherte Stand friert auf dem letzten Wert ein, der einmal mit Retain gesetzt wurde. iOS-Geräte melden zudem sparsam und in kurzen Stößen, was die Fehldiagnose zusätzlich stützt.
Prüfung: Niemals aus dem retained Stand auf den Betrieb schließen. Stattdessen lange live mitschneiden, mindestens deutlich länger als das Meldeintervall des Geräts:
mosquitto_sub -h localhost -t 'owntracks/#' -v | tsEin kurzer Mitschnitt fällt bei sparsam meldenden Geräten genau in die Lücke und bestätigt den falschen Verdacht.
Lösung: Die Diagnose korrigieren, nicht das System. Es ist nichts kaputt. Ein manueller Publish in der App setzt das Retain-Flag und aktualisiert den gespeicherten Stand, das ist aber Kosmetik. Die eigentliche Erkenntnis steht auch in der Home-Assistant-Doku: Retained Messages überleben das Gerät, das sie erzeugt hat.
6. Zu wenige Punkte ist kein Verbindungsproblem
Symptom: Die Kette läuft, aber die Spur ist grob. Aufenthalte lassen sich nicht sauber erkennen, zwischen zwei Punkten liegen Kilometer.
Ursache: Der sparsame Melde-Modus der App. Er ist die Voreinstellung und schont den Akku, indem er selten und ereignisgesteuert meldet. Wer hier an der Verbindung sucht, sucht am falschen Ende.
Prüfung: Die Zeitabstände der eingehenden Nachrichten im Live-Mitschnitt aus Stolperstein 5 ansehen. Regelmäßige, aber weit auseinanderliegende Meldungen sind ein Modus-Thema, unregelmäßige Aussetzer ein Verbindungsthema.
Lösung: Den Melde-Modus situativ umschalten statt dauerhaft hochzudrehen. Das geht per Fernbefehl, siehe nächster Abschnitt.
Fernbefehle: den Melde-Modus umschalten
OwnTracks nimmt auf dem /cmd-Zweig Befehle entgegen. Mit setConfiguration lässt sich der Melde-Modus umschalten, mit reportLocation eine sofortige Meldung anfordern. Das setzt voraus, dass Remote Commands auf dem Gerät aktiviert ist, worauf die Doku zur Fernkonfiguration ausdrücklich hinweist.
Ein Detail entscheidet über Erfolg oder Misserfolg, und es steht wörtlich in der OwnTracks-Doku zum Nachrichtentyp cmd: Erwarten Sie nicht, dass das Gerät online ist, senden Sie mit QoS größer 0, dann empfängt und beantwortet es den Befehl beim nächsten Aufwachen.
Für iOS-Geräte ist das nicht optional, sondern die einzige Chance. Sie verbinden sich in kurzen Stößen. Ein Befehl mit QoS 0 in ein Fenster gesendet, in dem das Gerät gerade nicht verbunden ist, ist ersatzlos weg. Mit QoS 1 und persistenter Sitzung hält der Broker ihn vor, bis das Gerät das nächste Mal auftaucht.
Damit wird aus dem Kompromiss zwischen Akku und Genauigkeit eine Automation: dichter melden, wenn es darauf ankommt, sparsam melden im Normalfall.
Grenzen und Verantwortung
Diese Kette hat mehr bewegliche Teile als ein fertiger Dienst. Broker, Bridge, Feeder, Auswertung und Home Assistant sind fünf Stellen, an denen etwas stehen bleiben kann. Sie brauchen dafür ein Backup der Historie und die Bereitschaft, gelegentlich in Logs zu sehen. Wer das nicht will, ist mit einem fertigen Dienst ehrlicher bedient.
Der wichtigere Punkt ist aber kein technischer. Ein Standort-Tracking erfasst nicht nur Sie. Sobald die Geräte anderer Menschen mitlaufen, erheben Sie deren Bewegungsdaten, und zwar lückenlos. Das gehört vorher offen besprochen und nicht stillschweigend eingerichtet, unabhängig davon, wie sicher die Kette technisch ist. Datenhoheit heißt auch, dass jemand die Hoheit hat, und diese Person trägt Verantwortung für alle anderen im System.
Sie wollen Automatisierung, die auf Anwesenheit reagiert, ohne die Standortdaten wegzugeben? Ich baue solche Ketten so, dass die sensiblen Daten bei Ihnen bleiben und nur das Nötigste überhaupt nach außen geht. Mehr unter Private Cloud, das Erstgespräch ist unverbindlich.

Alex Jabi
Ich betreue IT, Informationssicherheit und Datenschutz für KMU und Praxen an der Bergstraße und im Odenwald, persönlich, dokumentiert und ohne Cloud-Zwang.
Mehr über mich