· Kubernetes · 8 Min. Lesezeit
Trivy auf Kubernetes: die vollständige Stolperstein-Sammlung
Vierzehn dokumentierte Fallen beim Betrieb des Trivy-Operators, jede nach dem Schema Symptom, Ursache, Prüfung und Lösung. Von der Ratenbegrenzung beim Datenbank-Download über die gespiegelte Registry und den Supply-Chain-Vorfall vom März 2026 bis zu CRD-Änderungen beim Upgrade.
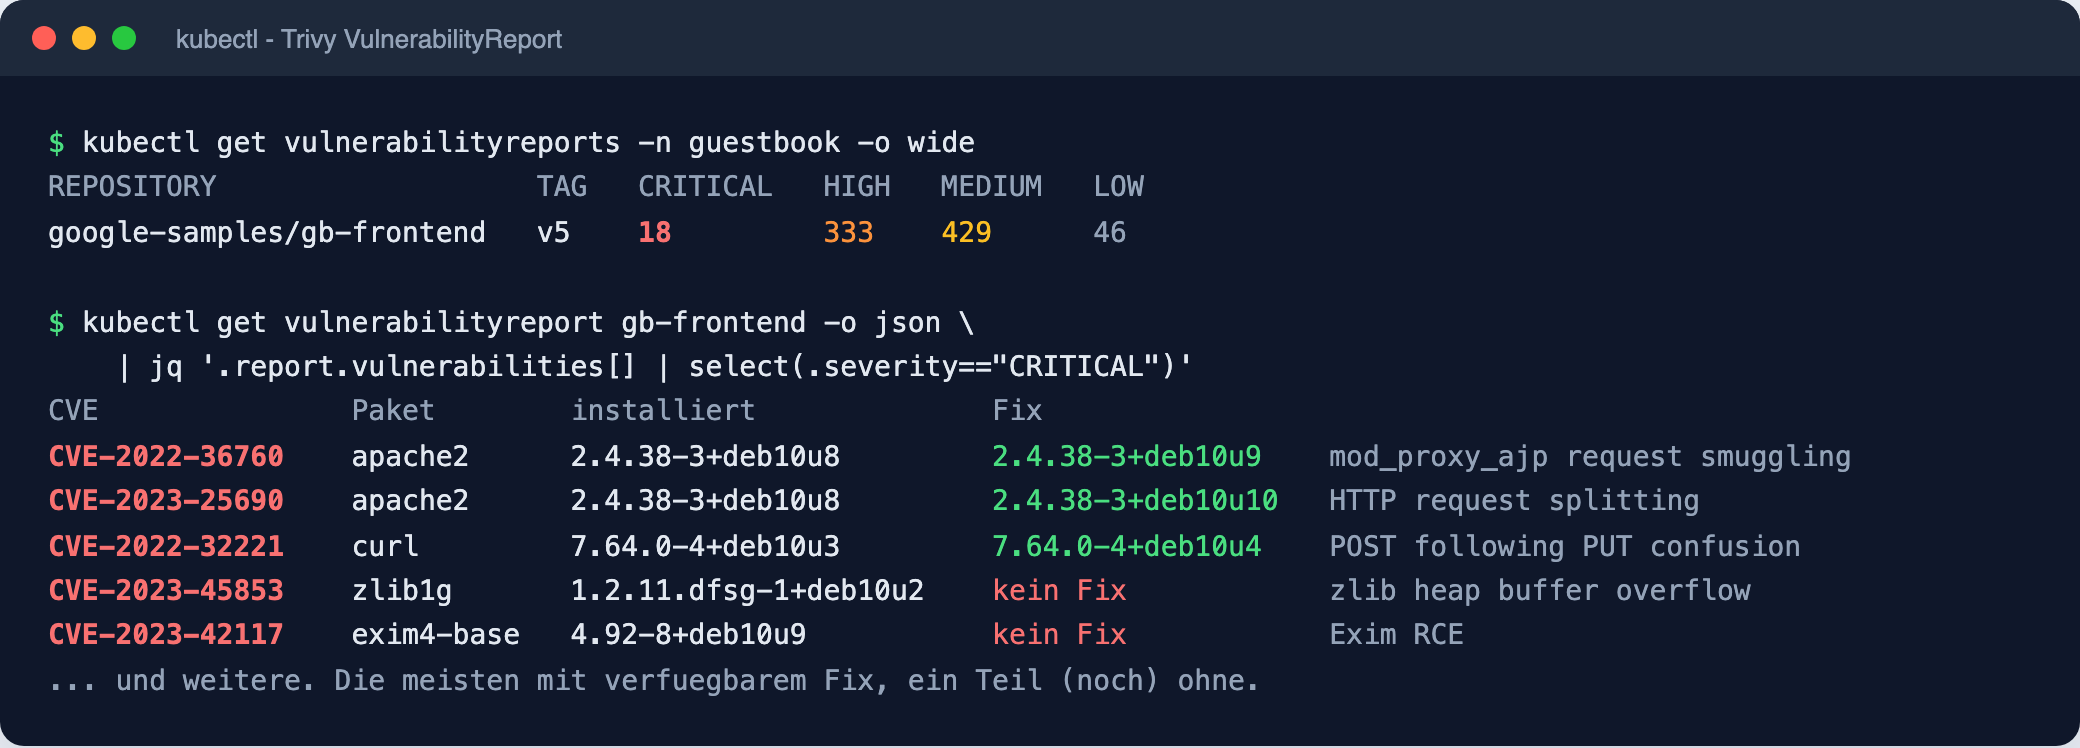
Ein Schwachstellen-Scanner, der stillschweigend nichts findet, ist gefährlicher als gar kein Scanner. Genau das ist die Klasse von Problemen, um die es hier geht. Fast alle Einträge dieser Sammlung führen dazu, dass Berichte fehlen, leer bleiben oder veraltet sind, ohne dass eine Fehlermeldung an prominenter Stelle darauf hinweist.
Die Sammlung ist für Sie gedacht, wenn Sie den Operator bereits ausgerollt haben und ein konkretes Verhalten einordnen müssen. Sie können sie ebenso vorab durchgehen, bevor Sie den Operator in einer abgeschotteten oder streng segmentierten Umgebung in Betrieb nehmen, weil ein Teil der Fallen dort planbar auftritt. Die drei folgenreichsten Einträge, also die Nummern 1, 2 und 8, sind zusätzlich im Hauptbeitrag aufgeführt. Hier stehen sie erneut, damit die Sammlung vollständig bleibt.
Alle Angaben stammen aus der Hersteller-Dokumentation und den offiziellen Release-Hinweisen.
1. Scan-Jobs brechen beim Datenbank-Download ab
Symptom: Scan-Jobs schlagen sporadisch fehl, besonders in größeren Clustern. Reports entstehen nur lückenhaft.
Ursache: Im Standardmodus Standalone lädt jeder einzelne Scan-Job die Datenbank neu von GitHub. Die Dokumentation weist ausdrücklich darauf hin, dass häufige Downloads in eine Ratenbegrenzung laufen können, die GitHub für alle anonymen Anfragen einer IP durchsetzt.
Prüfung:
kubectl logs -n trivy-system -l app.kubernetes.io/managed-by=trivy-operator \
  --all-containers --tail=50
Lösung: Entweder den Schlüssel trivy.githubToken im Secret trivy-operator hinterlegen, oder auf den Modus ClientServer umstellen. Der zweite Weg löst zugleich das Effizienzproblem, weil sich dann alle Scans eine Datenbank teilen.
2. Deny-all-Egress trifft die Scan-Pods, nicht den Operator
Symptom: Scan-Jobs entstehen, aber es gibt keine oder leere Reports. Eine NetworkPolicy für das Operator-Deployment hat nichts geändert.
Ursache: Die Troubleshooting-Seite stellt klar, dass der Operator selbst die Datenbank gar nicht herunterlädt. Das tun die von ihm erzeugten Scan-Pods, und zwar über Port 443. Eine Freigabe nur für das Deployment greift deshalb ins Leere.
Prüfung:
kubectl get pods -n trivy-system -l app.kubernetes.io/managed-by=trivy-operator
kubectl describe pod <POD-NAME> -n trivy-system
Lösung: Die NetworkPolicy auf die Scan-Pods anwenden, erkennbar am Label app.kubernetes.io/managed-by: trivy-operator. Freizugeben sind TCP 443 nach außen, TCP und UDP 53 Richtung kube-system für DNS sowie der Zugriff auf die Kube-API. Im Modus mit Trivy-Server kommt TCP 4954 als Ingress zu Pods mit dem Label app.kubernetes.io/name: trivy hinzu.
3. Die gespiegelte Datenbank wird nicht akzeptiert
Symptom: Das Datenbank-Image liegt in der internen Registry, die Scan-Jobs finden es trotzdem nicht oder können es nicht verarbeiten.
Ursache: Zwei dokumentierte Gründe kommen infrage. Erstens nutzen trivy-db und trivy-java-db nicht standardisierte OCI-Media-Types, die beim Kopieren verloren gehen können. Zweitens verwendet Trivy ohne expliziten Tag die Schema-Nummer statt latest, sucht also :2 beziehungsweise :1.
Prüfung:
oras manifest fetch registry.lab.rz.jabi-it.de/aquasec/trivy-db:2Im Manifest muss der Layer den Media-Type application/vnd.aquasec.trivy.db.layer.v1.tar+gzip tragen, bei der Java-Datenbank entsprechend application/vnd.aquasec.trivy.javadb.layer.v1.tar+gzip.
Lösung: Media-type-erhaltend spiegeln und die Tags 2 und 1 beibehalten. Als Notlösung beschreibt die Doku auch das manuelle Befüllen des Cache-Verzeichnisses.
mkdir -p ${TRIVY_CACHE_DIR}/db
cp /path/to/trivy.db /path/to/metadata.json ${TRIVY_CACHE_DIR}/db/
4. Kein Rückfall auf die offizielle Quelle
Symptom: Nach dem Umbiegen auf die interne Registry funktionieren die Scans intern. Fällt die interne Registry aus, schlagen sie fehl, statt auf die öffentliche Quelle auszuweichen.
Ursache: Das Setzen der Repository-Flags überschreibt laut Doku die Standardwerte vollständig, einschließlich der offiziellen Adressen mirror.gcr.io/aquasec und ghcr.io/aquasecurity, die Trivy sonst in dieser Reihenfolge abfragt.
Prüfung:
kubectl get cm trivy-operator-trivy-config -n trivy-system -o yamlLösung: Die Flags --db-repository und --java-db-repository akzeptieren mehrere Werte als Fallback-Kette. Wo ein Rückfall erwünscht ist, geben Sie die offizielle Adresse zusätzlich an. In einer echten Air-Gap-Umgebung ist der fehlende Fallback dagegen genau das gewünschte Verhalten.
5. Ein Satz Zugangsdaten für beide Datenbanken
Symptom: Der Datenbank-Download aus der internen Registry scheitert an der Authentifizierung, obwohl die Zugangsdaten korrekt sind.
Ursache: Der Operator erlaubt per Design keine unterschiedlichen Benutzernamen und Passwörter für mehrere Registries. Die Authentifizierung richtet sich nach der Registry aus trivy.dbRepository.
Prüfung:
kubectl get cm trivy-operator-trivy-config -n trivy-system \
  -o jsonpath='{.data.trivy\.dbRepository}{"\n"}{.data.trivy\.javaDbRepository}'
Lösung: Beide Datenbanken in dieselbe Registry spiegeln und alle vier Schlüssel konsistent darauf zeigen lassen.
6. Ein Workload-Typ taucht nie auf
Symptom: Für eine bestimmte Art von Workload entsteht nie ein Report.
Ursache: Der Operator scannt nur die in OPERATOR_TARGET_WORKLOADS aufgeführten Typen. Der Standard umfasst pod,replicaset,replicationcontroller,statefulset,daemonset,cronjob,job. Zusätzlich schränken OPERATOR_TARGET_NAMESPACES und OPERATOR_EXCLUDE_NAMESPACES den Umfang ein.
Prüfung:
kubectl get cm trivy-operator-config -n trivy-system -o yamlLösung: Die drei Schlüssel in trivy-operator-config an den gewünschten Umfang anpassen.
7. Scans großer Images brechen vor dem Report ab
Symptom: Der Scan-Job endet, ohne dass ein Report entsteht.
Ursache: Der Scan-Job läuft mit einem Standard-Timeout von fünf Minuten, sichtbar in OPERATOR_SCAN_JOB_TIMEOUT und im Chart-Wert scanJobTimeout. Auch die Ressourcengrenzen des Scanners sind begrenzt.
Prüfung:
kubectl get jobs -n trivy-system
kubectl describe job <JOB-NAME> -n trivy-system
Achten Sie auf DeadlineExceeded oder OOMKilled.
Lösung: scanJobTimeout und trivy.timeout heraufsetzen und die Werte unter trivy.resources anheben.
8. Das Löschen der CRDs nimmt die Historie mit
Symptom: Nach einer Deinstallation und Neuinstallation sind sämtliche bisherigen Berichte verschwunden.
Ursache: Die Installationsanleitung warnt ausdrücklich davor. Das Löschen der Custom Resource Definitions entfernt alle vom Operator erzeugten Security-Reports dauerhaft.
Prüfung:
kubectl get crd | grep aquasecurity.github.ioLösung: Beim Deinstallieren die CRDs stehen lassen, wenn die Historie erhalten bleiben soll. Wer die Berichte auswerten will, sichert sie vorher.
kubectl get vulnerabilityreports -A -o yaml > reports.yaml9. apt-get upgrade liefert keine neuen Trivy-Versionen mehr
Symptom: Auf einem Build-Host bleibt Trivy auf dem alten Stand, obwohl das Repository eingebunden ist.
Ursache: Ab v0.72.0 veröffentlicht das offizielle APT-Repository neue Releases nur noch in die Distribution generic. Distributionen pro Codename werden nicht mehr aktualisiert.
Prüfung:
cat /etc/apt/sources.list.d/trivy.list
apt-cache policy trivy
Lösung: In der Repository-Zeile den Codenamen durch generic ersetzen, danach apt-get update. Die Candidate-Version muss anschließend den erwarteten Stand nennen.
10. Die Pipeline bleibt auf 0.71.2 eingefroren
Symptom: Ein CI-Job zieht weiterhin Trivy 0.71.2, obwohl auf eine neuere Version gezeigt wird.
Ursache: Ab v0.72.0 veröffentlicht das Projekt keine architekturspezifischen Container-Image-Tags mehr, etwa 0.71.2-amd64 oder latest-arm64. Das letzte Release mit solchen Tags ist v0.71.2 vom 19. Juni 2026. Wer sie gepinnt hat, bleibt auf v0.71.2 stehen.
Prüfung: trivy --version im Job-Log gegen die erwartete Version abgleichen.
Lösung: Auf den einfachen Tag wechseln, also aquasec/trivy:0.72.0, oder per Digest pinnen.
11. Unklarheit nach dem Supply-Chain-Vorfall
Symptom: Es ist offen, ob eine eingesetzte Trivy-Version vom Vorfall im März 2026 betroffen ist.
Ursache: Am 19. März 2026 wurden über eine kompromittierte Zugangsberechtigung schadhafte Releases von trivy in Version v0.69.4 sowie von trivy-action und setup-trivy veröffentlicht. Am 22. März 2026 folgten schadhafte Docker-Hub-Images in den Versionen v0.69.5 und v0.69.6.
Prüfung:
trivy --version
kubectl get cm trivy-operator-trivy-config -n trivy-system -o yaml
Lösung: Auf gepinnte sichere Releases wechseln. Die Maintainer nennen trivy v0.69.3, trivy-action v0.35.0 und setup-trivy v0.2.6 als sichere Stände. Wer den Verdacht hat, eine kompromittierte Version ausgeführt zu haben, behandelt laut Anweisung der Maintainer alle Pipeline-Secrets als kompromittiert und rotiert sie sofort.
12. Reports sehen aktuell aus, sind es aber nicht
Symptom: Die Berichte tragen frische Zeitstempel, melden aber keine neuen Funde.
Ursache: Bei selbst gehosteter Datenbank aktualisiert niemand automatisch die Quelle. Die Doku weist ausdrücklich darauf hin, dass die Datenbanken aktuell gehalten werden müssen, damit die Ergebnisse relevant bleiben.
Prüfung:
kubectl get vulnerabilityreports -A \
  -o custom-columns=NAME:.metadata.name,UPDATED:.report.updateTimestamp
Lösung: Einen wiederkehrenden Job einrichten, der trivy-db und trivy-java-db in die interne Registry spiegelt, und den Zeitstempel im gespiegelten Artefakt überwachen. Der Chart-Standardwert scannerReportTTL von 24h sorgt dafür, dass Berichte nicht unbegrenzt stehen bleiben.
13. Java-Abhängigkeiten bleiben im abgeschotteten Netz unbewertet
Symptom: Java-Anteile in Images werden unvollständig oder gar nicht bewertet.
Ursache: Trivy versucht für die Java-Analyse eine HTTPS-Verbindung zu https://repo.maven.apache.org/maven2.
Prüfung: Die Logs der Scan-Pods auf Verbindungsversuche und Timeouts Richtung repo.maven.apache.org durchsehen.
Lösung: Die Air-Gap-Dokumentation stellt klar, dass es keinen Ersatz für Maven Central im abgeschotteten Netz gibt. Der Verbindungsversuch lässt sich per --offline-scan unterbinden, die Einschränkung bleibt bestehen. Spiegeln Sie zusätzlich die trivy-java-db.
14. Auswertungen überleben ein Operator-Upgrade nicht
Symptom: Nach einem Upgrade greifen eigene Skripte oder Dashboards nicht mehr auf die Report-Felder zu.
Ursache: Das Projekt bezeichnet sich selbst als inkubierend. Auch bei angestrebter Rückwärtskompatibilität können sich APIs und Custom Resource Definitions ändern.
Prüfung:
kubectl get crd vulnerabilityreports.aquasecurity.github.io \
  -o jsonpath='{.spec.versions[*].name}'
Lösung: Vor jedem Upgrade die Release-Notes des Zielrelease lesen und die CRD-Versionen vorher und nachher vergleichen. Der Operator erscheint in dichter Folge, zuletzt v0.32.0 am 8. Juli 2026 nach v0.31.2 am 18. Juni 2026. Planen Sie eigene Auswertungen gegen aquasecurity.github.io/v1alpha1 als potenziell instabil ein.
Wie Sie diese Sammlung einsetzen
Ich gehe die Einträge 1 bis 5 vor der Inbetriebnahme in einem segmentierten Netz durch, weil sie sich vorab entscheiden lassen und danach teuer zu korrigieren sind. Die Einträge 9 bis 11 betreffen die Versorgung mit Trivy-Versionen und gehören in die Pflege der Build-Umgebung, nicht in den Cluster-Betrieb. Die Einträge 12 bis 14 sind Dauerthemen, die eine wiederkehrende Kontrolle brauchen, weil sie sich nicht einmalig abhaken lassen.
Den zugehörigen Aufbau mit Installation, ClientServer-Umstellung, gespiegelter Datenbank und den Grenzen des Verfahrens finden Sie im Hauptbeitrag Wissen, welche Lücken laufen: Schwachstellen-Scanning mit Trivy.
Sie wollen wissen, welche bekannten Lücken in Ihren laufenden Systemen stecken, bevor es jemand anders herausfindet? Ich richte kontinuierliches Schwachstellen-Scanning ein und mache aus den Funden einen abarbeitbaren Plan. Mehr unter IT-Sicherheit & ISMS, das Erstgespräch ist unverbindlich.

Alex Jabi
Ich betreue IT, Informationssicherheit und Datenschutz für KMU und Praxen an der Bergstraße und im Odenwald, persönlich, dokumentiert und ohne Cloud-Zwang.
Mehr über mich