· Kubernetes · 8 Min. Lesezeit
Wissen, welche Lücken laufen: Schwachstellen-Scanning mit Trivy
Der Trivy-Operator scannt die tatsächlich laufenden Workloads und legt das Ergebnis als Kubernetes-Ressource ab. Installation per Helm, Umstellung vom Standalone- auf den ClientServer-Modus, Spiegeln der Schwachstellen-Datenbank in die eigene Registry und die Fallen, die die Dokumentation dabei ausdrücklich benennt.
Ein Container-Image bringt fremde Software mit, und die altert. Was heute sauber ausgeliefert wurde, hat in einem halben Jahr öffentlich dokumentierte Lücken, ohne dass sich am Image etwas geändert hätte. Die Frage ist, ob jemand davon weiß.
Dieser Beitrag zeigt den Weg vom einmaligen Ad-hoc-Scan bis zum dauerhaft laufenden Operator, mit einem Prüfschritt nach jedem Schritt. Alle Angaben stammen aus der Hersteller-Dokumentation und den offiziellen Release-Hinweisen, die an den jeweiligen Stellen verlinkt sind.
Erst die Entscheidung: Ad-hoc oder dauerhaft
Trivy tritt in zwei Betriebsformen an, und die Wahl entscheidet über den Aufwand. Die CLI kann einen Cluster direkt abfragen. Der Operator wird laut Dokumentation innerhalb des Clusters installiert und scannt fortlaufend, wobei zwei Scanner-Modi zur Wahl stehen.
| Variante | Wann sinnvoll | Kosten |
|---|---|---|
trivy k8s von außen | Bestandsaufnahme, einmalige Prüfung, Compliance-Bericht auf Zuruf | kein Dauerbetrieb, jedes Ergebnis ist eine Momentaufnahme |
Operator im Modus Standalone (Default) | kleine Cluster, erster Aufbau | laut Doku die ineffizienteste Methode, jeder Scan-Job lädt die Datenbank selbst |
Operator im Modus ClientServer | alles, was über eine Handvoll Workloads hinausgeht | ein zusätzlicher Server-Bestandteil, dafür teilen sich alle Scans eine Datenbank |
Der Operator erzeugt dabei nicht nur Schwachstellen-Berichte. Die Projektdokumentation nennt acht Report-Typen, darunter VulnerabilityReport, ConfigAuditReport, ExposedSecretReport, RbacAssessmentReport und SbomReport.
Ich halte die Umstellung auf ClientServer für wichtiger als jede Feinjustierung der Severity-Filter. Ein Scanner, dessen Jobs am Datenbank-Download scheitern, liefert keine Ergebnisse, und ein Filter auf Ergebnissen, die es nicht gibt, hilft niemandem.
Schritt 1: Die CLI installieren
Unter Debian und Ubuntu läuft die Installation über das eigene APT-Repository des Projekts. Die entscheidende Zeile ist die Repository-Definition, deren Distribution generic heißt. Den Signaturschlüssel legen Sie vorab unter /usr/share/keyrings/trivy.gpg ab, den vollständigen Ablauf beschreibt die Installationsseite. Ohne Paketverwaltung geht es über das Installationsskript mit fixierter Version.
echo "deb [signed-by=/usr/share/keyrings/trivy.gpg] https://aquasecurity.github.io/trivy-repo/deb generic main" \
  | sudo tee -a /etc/apt/sources.list.d/trivy.list
sudo apt-get update
sudo apt-get install trivy
curl -sfL https://raw.githubusercontent.com/aquasecurity/trivy/main/contrib/install.sh \
| sudo sh -s -- -b /usr/local/bin v0.72.0Prüfung:
trivy --versionDie Ausgabe muss die erwartete Version nennen. Der aktuelle Stand der CLI ist v0.72.0 vom 30. Juni 2026. Wer Trivy als Container betreibt, sollte laut Doku ein persistentes Cache-Verzeichnis vom Host mounten, sonst lädt jeder Lauf die Datenbank erneut.
Schritt 2: Bestandsaufnahme ohne Installation im Cluster
Bevor Sie etwas ausrollen, verschaffen Sie sich einen Überblick. Die CLI arbeitet gegen den aktiven Kontext. Der zweite Aufruf liefert die Compliance-Sicht gegen die Pod-Security-Standards.
trivy k8s --report summary
trivy k8s --compliance=k8s-pss-baseline --report summary
Prüfung: Die Zusammenfassung listet die gefundenen Ressourcen. Erscheint sie leer, prüfen Sie den Kontext, bevor Sie das Ergebnis als gutes Zeichen deuten. Beachten Sie, dass --exclude-namespaces laut Doku nur für Cluster-Rollen bereitsteht, weil Trivy dafür eine vollständige Namespace-Liste braucht.
Schritt 3: Den Operator per Helm installieren
Für den Dauerbetrieb wandert Trivy in den Cluster. Die Installationsanleitung nennt das Chart-Repository und die Installation in einen eigenen Namespace mit fixierter Version:
helm repo add aqua https://aquasecurity.github.io/helm-charts/
helm repo update
helm install trivy-operator aqua/trivy-operator \
  --namespace trivy-system \
  --create-namespace \
  --version 0.34.0
--version bezeichnet die Version des Helm-Charts, nicht die des Operators. Chart 0.34.0 trägt laut appVersion den Operator v0.32.0, Chart 0.32.1 dagegen noch v0.30.1.
Für die Installation direkt aus der OCI-Registry ersetzen Sie aqua/trivy-operator durch oci://ghcr.io/aquasecurity/helm-charts/trivy-operator.
Prüfung:
helm list -n trivy-system
kubectl get deployment -n trivy-system
kubectl logs deployment/trivy-operator -n trivy-system
Schritt 4: Den ersten Report lesen
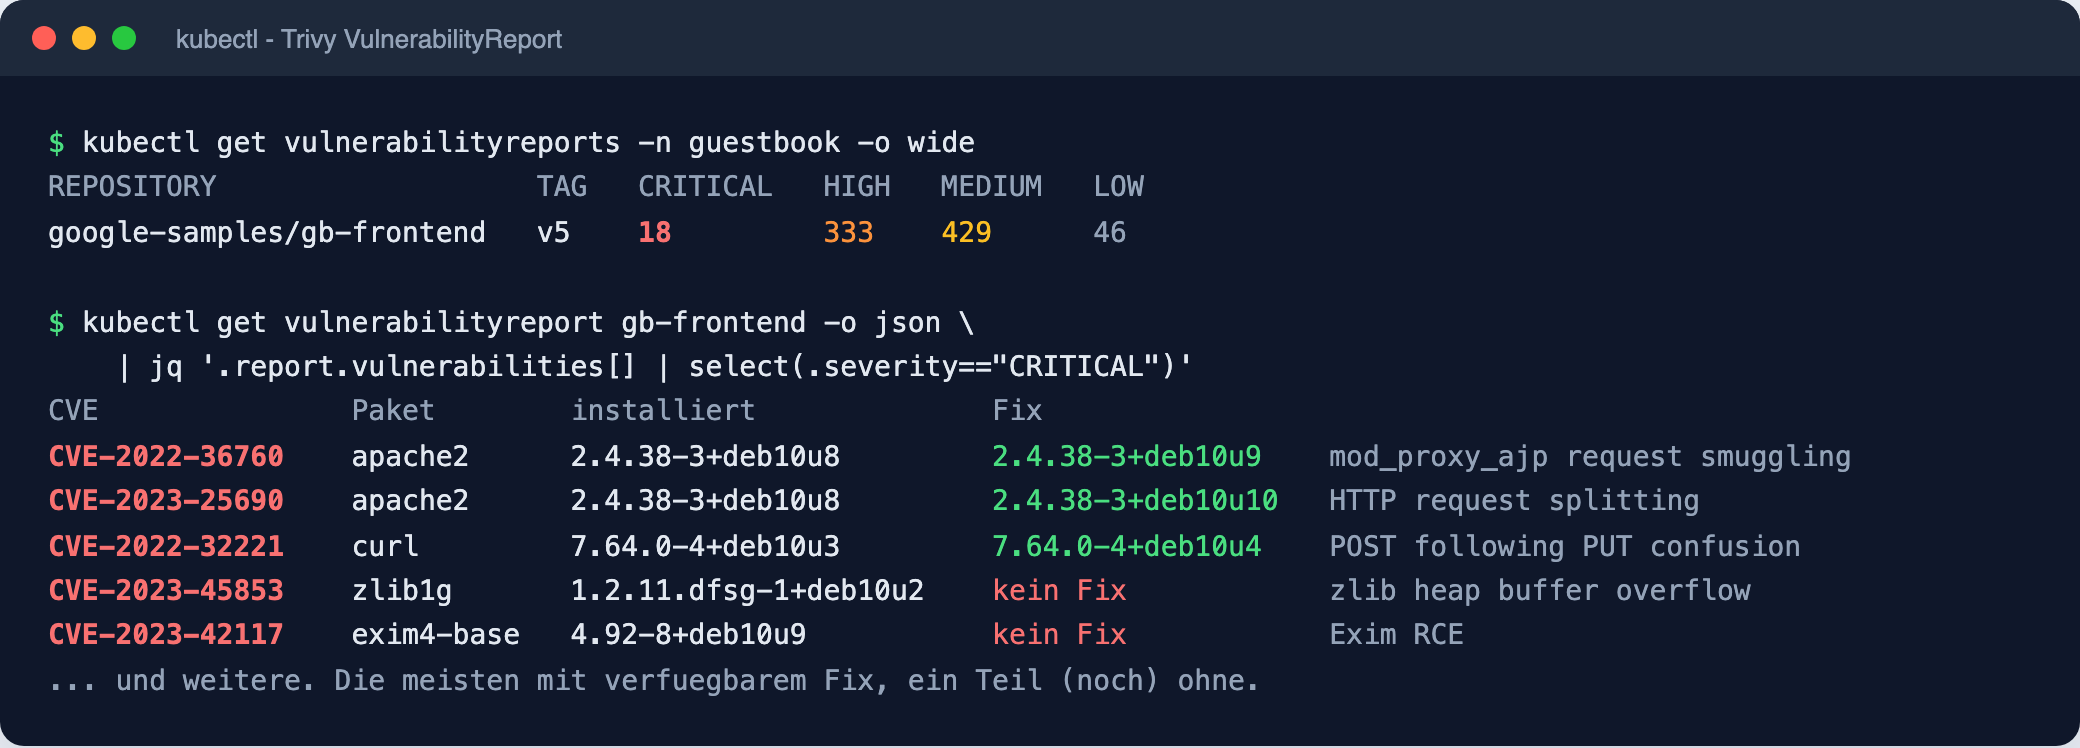
Der Quick-Start des Projekts nutzt ein bewusst altes Image als Demo-Workload. Kurz darauf liegt der Bericht als Custom Resource neben dem Workload:
kubectl create deployment nginx --image nginx:1.16
kubectl get vulnerabilityreports -o wide
Die Namen folgen der Konvention <workload kind>-<workload name>-<container-name>, ein Bericht heißt damit etwa replicaset-nginx-6d4cf56db6-nginx. Zum gezielten Filtern trägt jeder Report Labels wie trivy-operator.resource.kind und trivy-operator.resource.namespace. Im Feld report.summary stehen die Zähler criticalCount, highCount, mediumCount, lowCount und unknownCount.
Prüfung: Diese Abfrage macht aus der Report-Liste eine auswertbare Tabelle über alle Namespaces.
kubectl get vulnerabilityreports -A -o custom-columns=\
NAMESPACE:.metadata.namespace,\
NAME:.metadata.name,\
CRITICAL:.report.summary.criticalCount,\
HIGH:.report.summary.highCount,\
UPDATED:.report.updateTimestamp
Bleibt die Liste leer, obwohl Workloads laufen, springen Sie zu den Stolpersteinen 1 und 2 weiter unten.
Schritt 5: Vom Standalone- in den ClientServer-Modus
Der Operator startet im Modus Standalone. Laut Scanner-Dokumentation lädt dabei ein Init-Container in jedem Scan-Job-Pod die Datenbank von der GitHub-Releases-Seite. Die Doku nennt das ausdrücklich die ineffizienteste Methode. Im Modus ClientServer greifen alle Scans auf dieselbe Datenbank vom Server zu.
Der einfachste Weg ist der mitgelieferte Server über die Helm-Werte:
# values-trivy-operator.yaml
operator:
  builtInTrivyServer: true
helm upgrade trivy-operator aqua/trivy-operator \
--namespace trivy-system \
--version 0.34.0 \
-f values-trivy-operator.yamlZeigt der Cluster auf einen extern betriebenen Trivy-Server, setzen Sie stattdessen trivy.mode und trivy.serverURL direkt in der Scanner-ConfigMap:
kubectl patch cm trivy-operator-trivy-config -n trivy-system --type merge \
  -p '{"data":{"trivy.mode":"ClientServer","trivy.serverURL":"<TRIVY_SERVER_URL>"}}'
Prüfung: Die Ausgabe muss ClientServer lauten.
kubectl get cm trivy-operator-trivy-config -n trivy-system \
  -o jsonpath='{.data.trivy\.mode}'
Schritt 6: Die Datenbank aus der eigenen Registry beziehen
In abgeschotteten Netzen kommt kein Scan-Job an die öffentliche Quelle. Trivy liefert seine Datenbanken als OCI-Images aus, und die lassen sich spiegeln. Die Self-Hosting-Dokumentation nennt drei Artefakte: ghcr.io/aquasecurity/trivy-db:2, ghcr.io/aquasecurity/trivy-java-db:1 und ghcr.io/aquasecurity/trivy-checks.
oras pull ghcr.io/aquasecurity/trivy-db:2
oras pull ghcr.io/aquasecurity/trivy-java-db:1
Beim Weiterschieben in die eigene Registry müssen die nicht standardisierten Media-Types erhalten bleiben und die Tags 2 und 1 bestehen bleiben. Trivy verwendet ohne angegebenen Tag die Schema-Nummer statt latest. Anschließend zeigt der Operator auf die interne Quelle:
# values-trivy-operator.yaml
trivy:
  dbRegistry: "registry.lab.rz.jabi-it.de"
  dbRepository: "aquasec/trivy-db"
  javaDbRegistry: "registry.lab.rz.jabi-it.de"
  javaDbRepository: "aquasec/trivy-java-db"
  dbRepositoryUsername: "trivy-puller"
  dbRepositoryPassword: "<PASSWORT>"
Der Chart-Standard für diese Schlüssel ist mirror.gcr.io. Für Umgebungen ohne belastbares Zertifikat existiert zusätzlich dbRepositoryInsecure.
Prüfung: Erst das Artefakt in der Registry, dann die Konfiguration im Cluster.
oras manifest fetch registry.lab.rz.jabi-it.de/aquasec/trivy-db:2
kubectl get cm trivy-operator-trivy-config -n trivy-system -o yaml
In der ConfigMap müssen trivy.dbRepository und trivy.javaDbRepository auf dieselbe Registry zeigen. Der Operator erlaubt keine getrennten Zugangsdaten pro Registry. Wie eine solche interne Registry aufgebaut wird, steht im Beitrag Die eigene Registry mit Harbor.
Schritt 7: Umfang und Grenzen des Scans festlegen
Der Operator wird über zwei ConfigMaps gesteuert. trivy-operator-config enthält die Umgebung des Operators, trivy-operator-trivy-config die Scanner-Einstellungen. Wichtige Schlüssel sind OPERATOR_SCAN_JOB_TIMEOUT (Standard 5m) und OPERATOR_CONCURRENT_SCAN_JOBS_LIMIT (Standard 10). Mit OPERATOR_EXCLUDE_NAMESPACES nehmen Sie Namespaces per Kommaliste oder Glob-Muster aus.
kubectl patch cm trivy-operator-config -n trivy-system --type merge \
  -p '{"data":{"OPERATOR_EXCLUDE_NAMESPACES":"kube-system,kube-public"}}'
Prüfung:
kubectl get cm trivy-operator-config -n trivy-system -o yamlKontrollieren Sie hier auch OPERATOR_TARGET_WORKLOADS. Der Standard umfasst pod,replicaset,replicationcontroller,statefulset,daemonset,cronjob,job. Was dort fehlt, wird nicht gescannt.
Die drei folgenreichsten Stolpersteine
1. Scan-Jobs brechen beim Datenbank-Download ab
Symptom: Scan-Jobs schlagen sporadisch fehl, besonders in größeren Clustern. Reports entstehen nur lückenhaft.
Ursache: Im Standardmodus Standalone lädt jeder Scan-Job die Datenbank neu von GitHub. Die Doku weist ausdrücklich darauf hin, dass häufige Downloads in die Ratenbegrenzung laufen können, die GitHub für anonyme Anfragen einer IP durchsetzt.
Prüfung:
kubectl logs -n trivy-system -l app.kubernetes.io/managed-by=trivy-operator \
  --all-containers --tail=50
Lösung: Entweder trivy.githubToken im Secret trivy-operator hinterlegen, oder auf ClientServer umstellen wie in Schritt 5. Der zweite Weg löst zugleich das Effizienzproblem.
2. Deny-all-Egress trifft die Scan-Pods, nicht den Operator
Symptom: Scan-Jobs entstehen, aber es gibt keine oder leere Reports. Eine NetworkPolicy für das Operator-Deployment hat nichts geändert.
Ursache: Die Troubleshooting-Seite stellt klar, dass der Operator die Datenbank gar nicht selbst herunterlädt. Das tun die von ihm erzeugten Scan-Pods über Port 443. Eine Freigabe nur für das Deployment greift ins Leere.
Prüfung:
kubectl get pods -n trivy-system -l app.kubernetes.io/managed-by=trivy-operator
kubectl describe pod <POD-NAME> -n trivy-system
Lösung: Die NetworkPolicy auf die Scan-Pods anwenden, erkennbar am Label app.kubernetes.io/managed-by: trivy-operator. Freizugeben sind TCP 443 nach außen, TCP und UDP 53 Richtung kube-system sowie der Zugriff auf die Kube-API. Im Modus mit Trivy-Server kommt TCP 4954 als Ingress zu Pods mit app.kubernetes.io/name: trivy hinzu.
3. Das Löschen der CRDs nimmt die Historie mit
Symptom: Nach einer Deinstallation und Neuinstallation sind sämtliche bisherigen Berichte verschwunden.
Ursache: Die Installationsanleitung warnt ausdrücklich davor. Das Löschen der CRDs entfernt alle vom Operator erzeugten Security-Reports dauerhaft.
Prüfung:
kubectl get crd | grep aquasecurity.github.ioLösung: Beim Deinstallieren die CRDs stehen lassen. Wer die Berichte auswerten will, sichert sie vorher.
kubectl get vulnerabilityreports -A -o yaml > reports.yamlDie übrigen Fallen stehen im Begleitbeitrag
Diese drei Stolpersteine treffen den Regelbetrieb am härtesten, sie sind aber nicht alle. Die vollständige Sammlung der Stolpersteine steht im Beitrag Trivy auf Kubernetes: die vollständige Stolperstein-Sammlung. Dort stehen elf weitere Fälle im selben Schema, darunter die abgelehnte gespiegelte Datenbank, der fehlende Rückfall auf die offizielle Quelle, das Timeout bei großen Images, der Supply-Chain-Vorfall vom März 2026 und veraltete Datenbanken hinter frischen Zeitstempeln.
Grenzen
Ein Report ist kein Fix. Scanning findet Lücken, es schließt keine. Der Wert entsteht erst, wenn jemand die Berichte durchsieht, die kritischen Funde bewertet und die Images aktualisiert. Wie das zu einem nachvollziehbaren Prozess wird, steht in den Beiträgen Patch-Management mit Ansible und Abhängigkeiten mit Renovate.
Auch der Umfang hat Grenzen. Die KBOM-Auswertung der CLI, erzeugt mit trivy k8s --format cyclonedx, ist laut Doku auf reine Kubernetes-Distributionen ausgelegt und funktioniert bei Hersteller-Varianten und manchen Cloud-Managed-Distributionen nicht gut. Auf solchen Clustern behandeln Sie die Bewertung der Control Plane aus der KBOM nicht als verlässlich und stützen sich auf Image- und Workload-Scans.
Und schließlich ist der Operator selbst ein Stück Software im Cluster, das Rechte braucht, Jobs erzeugt und nach außen telefoniert. In einer streng abgeschotteten Umgebung ist der Aufwand für die gespiegelten Datenbanken nicht klein. Wer ihn nicht tragen will, fährt mit einem Scan an der Registry-Schleuse und regelmäßigen Ad-hoc-Läufen ehrlicher als mit einem In-Cluster-Scanner, dessen Jobs still an der Egress-Regel scheitern.
Sie wollen wissen, welche bekannten Lücken in Ihren laufenden Systemen stecken, bevor es jemand anders herausfindet? Ich richte kontinuierliches Schwachstellen-Scanning ein und mache aus den Funden einen abarbeitbaren Plan. Mehr unter IT-Sicherheit & ISMS, das Erstgespräch ist unverbindlich.

Alex Jabi
Ich betreue IT, Informationssicherheit und Datenschutz für KMU und Praxen an der Bergstraße und im Odenwald, persönlich, dokumentiert und ohne Cloud-Zwang.
Mehr über mich